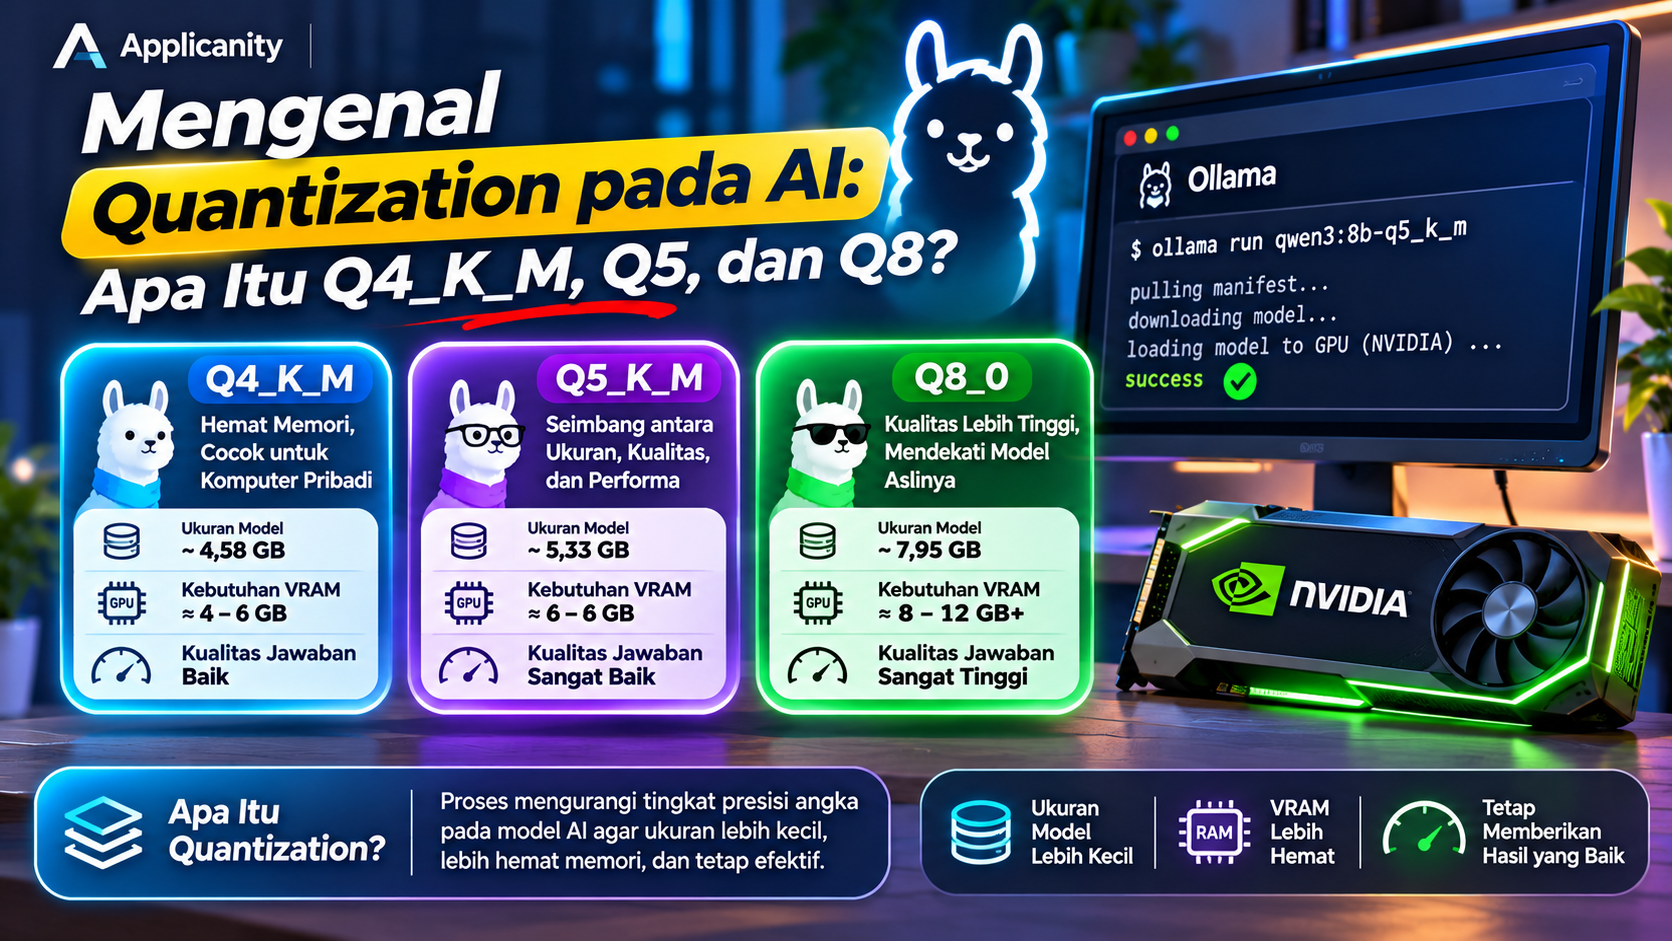
Mengenal Quantization pada AI: Apa Itu Q4_K_M, Q5, dan Q8?
Perkembangan teknologi Artificial Intelligence (AI) membuat semakin banyak orang tertarik menjalankan Large Language Model (LLM) secara lokal di komputer sendiri. Dengan bantuan aplikasi seperti Ollama, LM Studio, dan llama.cpp, pengguna dapat menjalankan AI tanpa harus selalu bergantung pada layanan cloud.
Namun, ketika mencari atau mengunduh model AI, kita sering menemukan beberapa pilihan versi seperti Q4_K_M, Q5_K_M, Q6_K, dan Q8_0. Meskipun menggunakan model dasar yang sama, setiap versi tersebut bisa memiliki ukuran file, kebutuhan memori, dan kualitas jawaban yang berbeda.
Perbedaan ini berkaitan dengan teknologi yang disebut quantization.
Apa sebenarnya quantization? Mengapa ada model AI dengan label Q4, Q5, atau Q8? Apakah semakin tinggi angkanya berarti semakin bagus? Dan versi mana yang sebaiknya dipilih untuk komputer pribadi?
Mari kita bahas satu per satu.
Apa Itu Quantization pada AI?
Quantization adalah proses mengurangi tingkat presisi angka yang digunakan untuk menyimpan parameter atau bobot (weights) sebuah model AI.
Untuk memahami konsep ini, kita perlu mengetahui bahwa model AI memiliki banyak parameter yang berisi angka-angka. Angka tersebut digunakan model untuk mempelajari pola, memahami konteks, dan menghasilkan jawaban.
Dalam proses penyimpanan model, angka-angka tersebut dapat menggunakan format dengan tingkat presisi tertentu, misalnya 16-bit atau 32-bit. Semakin tinggi presisinya, biasanya semakin besar ruang penyimpanan dan memori yang dibutuhkan.
Quantization mengubah representasi angka tersebut menjadi format dengan jumlah bit yang lebih rendah. Tujuannya adalah mengurangi ukuran model dan kebutuhan memori agar model AI lebih mudah dijalankan pada perangkat dengan spesifikasi terbatas.
Sebagai gambaran sederhana, bayangkan kita menyimpan hasil pengukuran.
-
Nilai dengan presisi tinggi dapat menyimpan angka secara lebih detail.
-
Nilai dengan presisi lebih rendah menggunakan representasi yang lebih sederhana.
-
Hasilnya membutuhkan ruang lebih sedikit, tetapi sebagian detail angka mungkin tidak dapat dipertahankan secara sempurna.
Hal serupa terjadi pada parameter model AI. Ketika model dikuantisasi, sebagian informasi numerik dapat mengalami perubahan kecil. Perubahan ini berpotensi memengaruhi kualitas jawaban yang dihasilkan.
Dengan kata lain, quantization merupakan proses mencari keseimbangan antara ukuran model, kebutuhan memori, performa, dan kualitas hasil AI.
Mengapa Quantization Penting?
Salah satu tantangan terbesar ketika menjalankan AI secara lokal adalah kebutuhan hardware.
Model AI dengan ukuran besar membutuhkan memori yang cukup besar, terutama ketika seluruh atau sebagian besar model harus dimuat ke GPU. Tidak semua komputer memiliki GPU dengan VRAM yang memadai.
Sebagai contoh, model dengan 8 miliar parameter dalam format FP16 membutuhkan sekitar 16 GB ruang hanya untuk menyimpan bobot model secara teoritis. Dalam praktiknya, kebutuhan memori total bisa lebih besar karena aplikasi juga membutuhkan ruang untuk cache, konteks percakapan, dan proses komputasi lainnya.
Dengan quantization, kebutuhan penyimpanan bobot model dapat dikurangi secara signifikan.
Beberapa manfaat utama quantization antara lain:
-
Ukuran file lebih kecil. Model dapat disimpan menggunakan ruang disk yang lebih sedikit.
-
Kebutuhan RAM dan VRAM lebih rendah. Model yang sebelumnya terlalu besar mungkin dapat dijalankan pada komputer dengan spesifikasi lebih terbatas.
-
Membuka akses ke model yang lebih besar. Pengguna dapat mencoba model dengan jumlah parameter lebih banyak tanpa harus memiliki hardware kelas server.
-
Potensi peningkatan kecepatan inference. Pada kondisi tertentu, model yang lebih kecil dapat menghasilkan respons lebih cepat karena jumlah data yang perlu dipindahkan dari memori menjadi lebih sedikit.
Namun, perlu diingat bahwa quantization tidak selalu membuat model lebih cepat. Kecepatan juga dipengaruhi oleh jenis GPU, CPU, bandwidth memori, software yang digunakan, dan ukuran konteks. Format dengan bit lebih rendah bahkan dapat memiliki proses komputasi tambahan yang memengaruhi performa.
Memahami Arti Q4, Q5, dan Q8
Ketika melihat nama seperti Q4_K_M atau Q8_0, huruf Q merujuk pada quantization, sedangkan angka menunjukkan kelompok tingkat presisi yang digunakan dalam representasi bobot.
Secara sederhana:
-
Q4: menggunakan kelompok representasi sekitar 4-bit.
-
Q5: menggunakan kelompok representasi sekitar 5-bit.
-
Q8: menggunakan kelompok representasi sekitar 8-bit.
Semakin banyak bit yang digunakan, semakin banyak kemungkinan nilai yang dapat direpresentasikan. Hal ini biasanya membantu mempertahankan informasi model dengan lebih baik.
Namun, angka tersebut bukan berarti seluruh file model menggunakan tepat 4, 5, atau 8 bit untuk setiap parameter. Format quantization modern menggunakan struktur blok, skala, dan metadata tambahan. Karena itu, kebutuhan ukuran sebenarnya biasanya sedikit lebih besar daripada angka bit dasarnya.
Mari kita bahas format yang paling sering ditemukan.
1. Q4_K_M: Pilihan Seimbang untuk Komputer Pribadi
Q4_K_M merupakan salah satu format quantization yang populer untuk menjalankan LLM secara lokal.
Format ini termasuk keluarga K-quant yang digunakan oleh ekosistem llama.cpp dan GGUF. Berbeda dari pendekatan quantization sederhana, K-quant menggunakan pengelompokan bobot dan informasi skala tambahan untuk mengatur representasi angka.
Huruf pada namanya memiliki arti:
-
Q4: kelompok quantization dengan basis sekitar 4-bit.
-
K: termasuk keluarga K-quant.
-
M: menunjukkan varian Medium.
Varian M bukan berarti seluruh bobot menggunakan format yang sama. Dalam implementasi llama.cpp, beberapa bagian model yang dianggap lebih sensitif dapat diberikan presisi lebih tinggi untuk membantu mempertahankan kualitas.
Kelebihan Q4_K_M
-
Ukuran model relatif kecil.
-
Kebutuhan VRAM lebih rendah dibandingkan Q5 atau Q8.
-
Kualitas jawaban umumnya masih baik untuk banyak penggunaan sehari-hari.
-
Cocok untuk komputer pribadi dan GPU dengan kapasitas memori terbatas.
Kekurangan Q4_K_M
-
Sebagian informasi bobot lebih banyak dikompresi dibandingkan Q5 atau Q8.
-
Pada tugas tertentu, kualitas jawaban dapat mengalami penurunan.
-
Model yang sangat bergantung pada ketelitian instruksi atau penalaran tertentu mungkin menunjukkan perbedaan hasil.
Q4_K_M sering menjadi titik awal yang masuk akal bagi pengguna yang ingin menjalankan AI lokal dengan kebutuhan memori lebih hemat.
2. Q5 dan Q5_K_M: Keseimbangan antara Ukuran dan Kualitas
Q5 menggunakan kelompok representasi sekitar 5-bit. Dalam keluarga K-quant, salah satu format yang umum ditemukan adalah Q5_K_M.
Dibandingkan Q4_K_M, Q5_K_M biasanya membutuhkan ruang penyimpanan dan memori lebih besar. Sebagai gantinya, format ini dapat mempertahankan informasi bobot dengan lebih baik.
Kelebihan Q5_K_M
-
Kualitas model umumnya lebih dekat dengan versi presisi tinggi.
-
Cocok untuk tugas yang membutuhkan jawaban lebih konsisten.
-
Menjadi pilihan menarik jika kapasitas VRAM masih mencukupi.
-
Dapat memberikan kompromi yang baik antara ukuran dan kualitas.
Kekurangan Q5_K_M
-
Ukuran file lebih besar daripada Q4_K_M.
-
Membutuhkan RAM atau VRAM lebih banyak.
-
Tidak selalu memberikan peningkatan kecepatan dibandingkan Q4_K_M.
Q5_K_M cocok bagi pengguna yang ingin mendapatkan kualitas lebih baik tanpa harus menggunakan model berukuran sebesar Q8_0.
Perlu diperhatikan bahwa istilah Q5 tidak selalu berarti Q5_K_M. Ada beberapa varian, seperti Q5_0, Q5_1, Q5_K_S, dan Q5_K_M. Masing-masing memiliki metode penyimpanan dan karakteristik yang berbeda.
3. Q8_0: Mempertahankan Kualitas dengan Presisi Lebih Tinggi
Q8_0 merupakan format quantization dengan representasi sekitar 8-bit. Dibandingkan Q4_K_M dan Q5_K_M, format ini mempertahankan presisi bobot yang lebih tinggi.
Dalam banyak penggunaan, hasil Q8_0 dapat sangat mendekati model dengan presisi FP16. Namun, Q8_0 tetap merupakan model yang sudah dikuantisasi, bukan salinan identik dari model aslinya.
Kelebihan Q8_0
-
Kualitas hasil umumnya sangat dekat dengan model FP16.
-
Perubahan akibat quantization relatif kecil.
-
Cocok untuk eksperimen atau pekerjaan yang mengutamakan kualitas.
-
Menjadi pilihan ketika kapasitas memori bukan kendala utama.
Kekurangan Q8_0
-
Ukuran file lebih besar.
-
Membutuhkan RAM dan VRAM lebih banyak.
-
Kecepatan inference belum tentu lebih tinggi daripada Q4 atau Q5.
-
Bisa menjadi kurang praktis untuk komputer dengan GPU berkapasitas memori terbatas.
Q8_0 cocok bagi pengguna yang lebih memprioritaskan kualitas dibandingkan penghematan memori.
Perbandingan Q4_K_M, Q5_K_M, dan Q8_0
Berikut gambaran umum perbedaan ketiga format tersebut.
| Aspek | Q4_K_M | Q5_K_M | Q8_0 |
|---|---|---|---|
| Kelompok presisi | Sekitar 4-bit | Sekitar 5-bit | Sekitar 8-bit |
| Ukuran model | Paling kecil | Menengah | Paling besar |
| Kebutuhan memori | Lebih rendah | Menengah | Lebih tinggi |
| Retensi kualitas | Baik | Sangat baik | Sangat tinggi |
| Penggunaan umum | AI lokal sehari-hari | Kualitas dan efisiensi seimbang | Kualitas menjadi prioritas |
Perbandingan ini bersifat umum. Ukuran file dan kualitas sebenarnya dapat berbeda tergantung arsitektur model, jumlah parameter, format file, dan implementasi quantization.
Contoh Perbedaan Ukuran Model 8B
Agar lebih mudah dipahami, kita dapat menggunakan model dengan sekitar 8 miliar parameter sebagai contoh.
Pada salah satu contoh model Llama 3.1 8B dalam format GGUF, ukuran file dapat berada di kisaran berikut:
| Format | Perkiraan Ukuran |
|---|---|
| FP16 | 14,96 GiB |
| Q8_0 | 7,95 GiB |
| Q5_K_M | 5,33 GiB |
| Q4_K_M | 4,58 GiB |
Angka tersebut merupakan contoh dari model tertentu, bukan ukuran tetap untuk semua model 8B.
Dari contoh tersebut, terlihat bahwa Q4_K_M membutuhkan ruang penyimpanan jauh lebih kecil dibandingkan FP16. Q5_K_M berada di antara Q4_K_M dan Q8_0, sedangkan Q8_0 mempertahankan presisi lebih tinggi dengan kebutuhan memori lebih besar.
Perlu diingat bahwa ukuran file bukan satu-satunya faktor penentu kebutuhan VRAM. Saat menjalankan model, aplikasi juga membutuhkan memori untuk context window, KV cache, dan proses lainnya. Karena itu, GPU dengan VRAM 8 GB belum tentu dapat menjalankan setiap model 8B Q8_0 secara nyaman.
Apa Perbedaan Q4_K_M dengan Q4_K_S?
Selain Q4_K_M, pengguna juga mungkin menemukan Q4_K_S.
Keduanya termasuk keluarga K-quant, tetapi memiliki konfigurasi quantization yang berbeda.
Secara umum:
-
Q4_K_S (Small): lebih mengutamakan penghematan ukuran.
-
Q4_K_M (Medium): menggunakan konfigurasi yang dapat mempertahankan kualitas lebih baik dengan ukuran sedikit lebih besar.
Jika tersedia, Q4_K_M sering menjadi pilihan awal yang lebih menarik untuk penggunaan umum. Namun, Q4_K_S juga dapat berguna ketika kapasitas memori benar-benar terbatas.
Hal serupa berlaku pada Q5_K_S dan Q5_K_M.
Apakah Quantization Mengurangi Kecerdasan AI?
Pertanyaan ini sering muncul ketika seseorang baru mengenal quantization.
Jawabannya: quantization dapat memengaruhi kualitas model, tetapi tidak otomatis membuat AI menjadi tidak pintar.
Model yang dikuantisasi tetap menggunakan arsitektur, struktur, dan hasil pelatihan dari model dasarnya. Yang berubah adalah cara sebagian bobot disimpan dan direpresentasikan.
Dampaknya dapat berbeda-beda tergantung jenis model dan tugas yang diberikan.
Misalnya:
-
Untuk percakapan sederhana, perbedaan Q4 dan Q8 mungkin tidak terlalu terasa.
-
Untuk tugas pemrograman, format dengan presisi lebih tinggi terkadang memberikan hasil yang lebih konsisten.
-
Untuk tugas penalaran yang kompleks, perbedaan kecil pada bobot dapat memengaruhi hasil.
-
Untuk tugas yang membutuhkan ketelitian angka, sebaiknya lakukan pengujian dengan model dan format yang akan digunakan.
Tidak ada jaminan bahwa Q8 selalu menghasilkan jawaban yang lebih baik pada setiap prompt. Hasil juga dipengaruhi oleh prompt, parameter sampling, konteks, dan karakteristik model.
Bagaimana Memilih Quantization yang Tepat?
Pemilihan quantization sebaiknya disesuaikan dengan kemampuan hardware dan kebutuhan penggunaan.
Berikut panduan sederhana:
Pilih Q4_K_M jika:
-
VRAM GPU terbatas.
-
Ingin menjalankan AI lokal untuk penggunaan sehari-hari.
-
Ingin mencoba model dengan parameter lebih besar.
-
Lebih mengutamakan efisiensi memori.
Pilih Q5_K_M jika:
-
Memiliki kapasitas RAM atau VRAM yang lebih lega.
-
Menginginkan keseimbangan antara ukuran dan kualitas.
-
Sering menggunakan AI untuk coding, analisis, atau pekerjaan produktif.
Pilih Q8_0 jika:
-
Memiliki kapasitas memori yang cukup.
-
Mengutamakan kualitas hasil.
-
Ingin membandingkan hasil quantization dengan model FP16.
-
Tidak terlalu mempermasalahkan ukuran file yang lebih besar.
Sebagai contoh, pengguna dengan GPU NVIDIA RTX 3060 12 GB VRAM dapat mulai mencoba model 7B atau 8B dalam format Q4_K_M maupun Q5_K_M. Q8_0 juga bisa dicoba pada model yang sesuai, tetapi tetap perlu memperhitungkan kebutuhan memori tambahan saat inference.
Cara Mengetahui Quantization Model di Ollama
Jika menggunakan Ollama, pengguna dapat memeriksa model yang sedang berjalan melalui terminal.
Jalankan perintah:
ollama ps
Perintah tersebut menampilkan informasi model yang sedang aktif, termasuk informasi terkait penggunaan GPU dan CPU.
Untuk melihat daftar model yang sudah diunduh, gunakan:
ollama list
Namun, informasi quantization tidak selalu ditampilkan secara lengkap melalui daftar tersebut. Pengguna dapat memeriksa detail model melalui halaman model di Ollama Library atau metadata model yang digunakan.
Jika mengunduh model dari Hugging Face, perhatikan nama file atau varian GGUF yang tersedia. Biasanya informasi quantization dicantumkan pada nama file, misalnya:
model-Q4_K_M.gguf
model-Q5_K_M.gguf
model-Q8_0.gguf
Pastikan juga bahwa format model tersebut kompatibel dengan aplikasi yang digunakan.
Apakah Model Q4 Selalu Lebih Cepat daripada Q8?
Tidak selalu.
Model Q4 biasanya memiliki ukuran lebih kecil sehingga jumlah data yang perlu dibaca dari memori dapat berkurang. Kondisi ini berpotensi meningkatkan kecepatan proses menghasilkan token.
Namun, kecepatan inference dipengaruhi banyak faktor, seperti:
-
Jenis dan kemampuan GPU.
-
Bandwidth memori.
-
Dukungan software terhadap format quantization.
-
Apakah model berjalan di GPU, CPU, atau kombinasi keduanya.
-
Panjang konteks percakapan.
-
Ukuran model dan arsitekturnya.
Pada beberapa perangkat, format yang lebih kecil dapat memberikan kecepatan lebih baik. Pada perangkat lain, perbedaannya mungkin kecil atau bahkan berbalik.
Karena itu, cara terbaik adalah melakukan pengujian langsung menggunakan hardware dan aplikasi yang akan digunakan.
Kesimpulan
Quantization merupakan teknologi penting yang membuat penggunaan AI lokal menjadi lebih mudah diakses. Dengan mengurangi presisi representasi bobot model, ukuran file dan kebutuhan memori dapat ditekan tanpa harus sepenuhnya mengorbankan kualitas.
Q4_K_M cocok sebagai pilihan awal untuk penggunaan umum karena menawarkan ukuran yang relatif kecil dengan kualitas yang masih baik. Q5_K_M menjadi pilihan menarik ketika pengguna menginginkan kualitas lebih tinggi dengan kebutuhan memori menengah. Sementara itu, Q8_0 cocok bagi pengguna yang mengutamakan retensi kualitas dan memiliki kapasitas memori lebih besar.
Tidak ada satu format yang selalu paling baik untuk semua kondisi. Pilihan terbaik adalah format yang sesuai dengan hardware, kebutuhan pekerjaan, dan hasil pengujian Anda sendiri.
Jika Anda sedang membangun lingkungan AI lokal, memahami quantization akan membantu menentukan model yang tepat agar komputer dapat menjalankan AI secara lebih efisien.